字号
本期编译精选。
大技术
元数据
这是Meta Superintelligence Lab(MSI)的最新发行。
2026年9月1日 5时56分
元数据
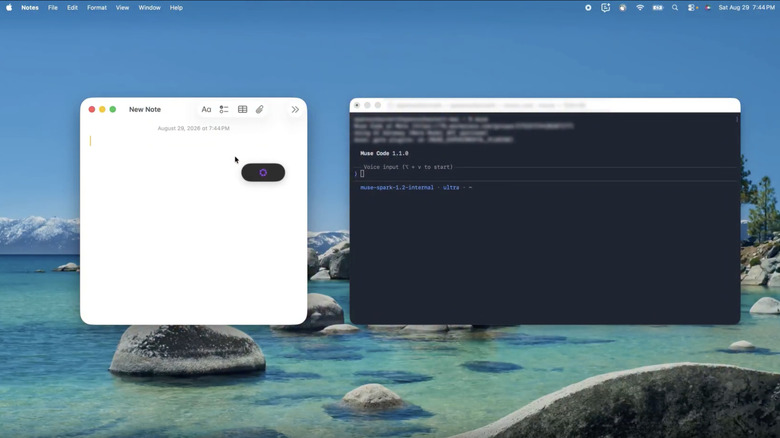
Meta引入了第一个实时音频模式Muse Voice Translatis. Meta说,该模型可以同时处理20多位演讲者的口述和抄写,并能无缝地处理多种语言。
Meta CEO Mark Zuckerberg在3年未在平台上发布后,最近回到了X,他分享了该模型同时处理多语种和语言能力的例子。在视频中,转录可以自动区分多语种,并互换语言。它甚至能够取出代码切换,并转录使用多语言词的句子。
Muse Voice Translatis是MSL的第一个实时音频感知模型——今天推出。SOTA在流式语音对文本中,它处理扬声器的对等化,并在本土上用单一的模型来指代。(原始内容存档于2013-10-12). pic. twitter.com/LVIMDSkbim
— 马克·扎克伯格 (@finkd) 2026年9月1日。
模特儿决定何时听。它在硬词上等得更久一点,在简单词上承诺更快,利用适应性的延迟来预测每个符号并增加准确性. 它坚守着杂乱无章,真实的音频太——训练了70多种语言(发布时验证了25种),处理中刑的代码切换,管理20多位演讲者长达一小时的会话。
Meta的发售在Google双子座3.5 Translacy之后不到一周,但Google正在将它的音频模型制成Android和(最终)Chrome时,并不清楚Meta是否有计划将Muse Voice Trancis纳入其旗舰服务。
(编译自 Engadget;原文
来源:Engadget(原文)
本文系本站对该英文资讯的编译与转述,非全文翻译;版权归原作者所有。
本文系本站对该英文资讯的编译与转述,非全文翻译;版权归原作者所有。
免费订阅
每天 5 分钟,看懂世界在发生什么
订阅「牛金金天天译站」,每日精选海外科技/AI/文化资讯编译送到你邮箱。非经营性、无广告、可随时退订。
评论